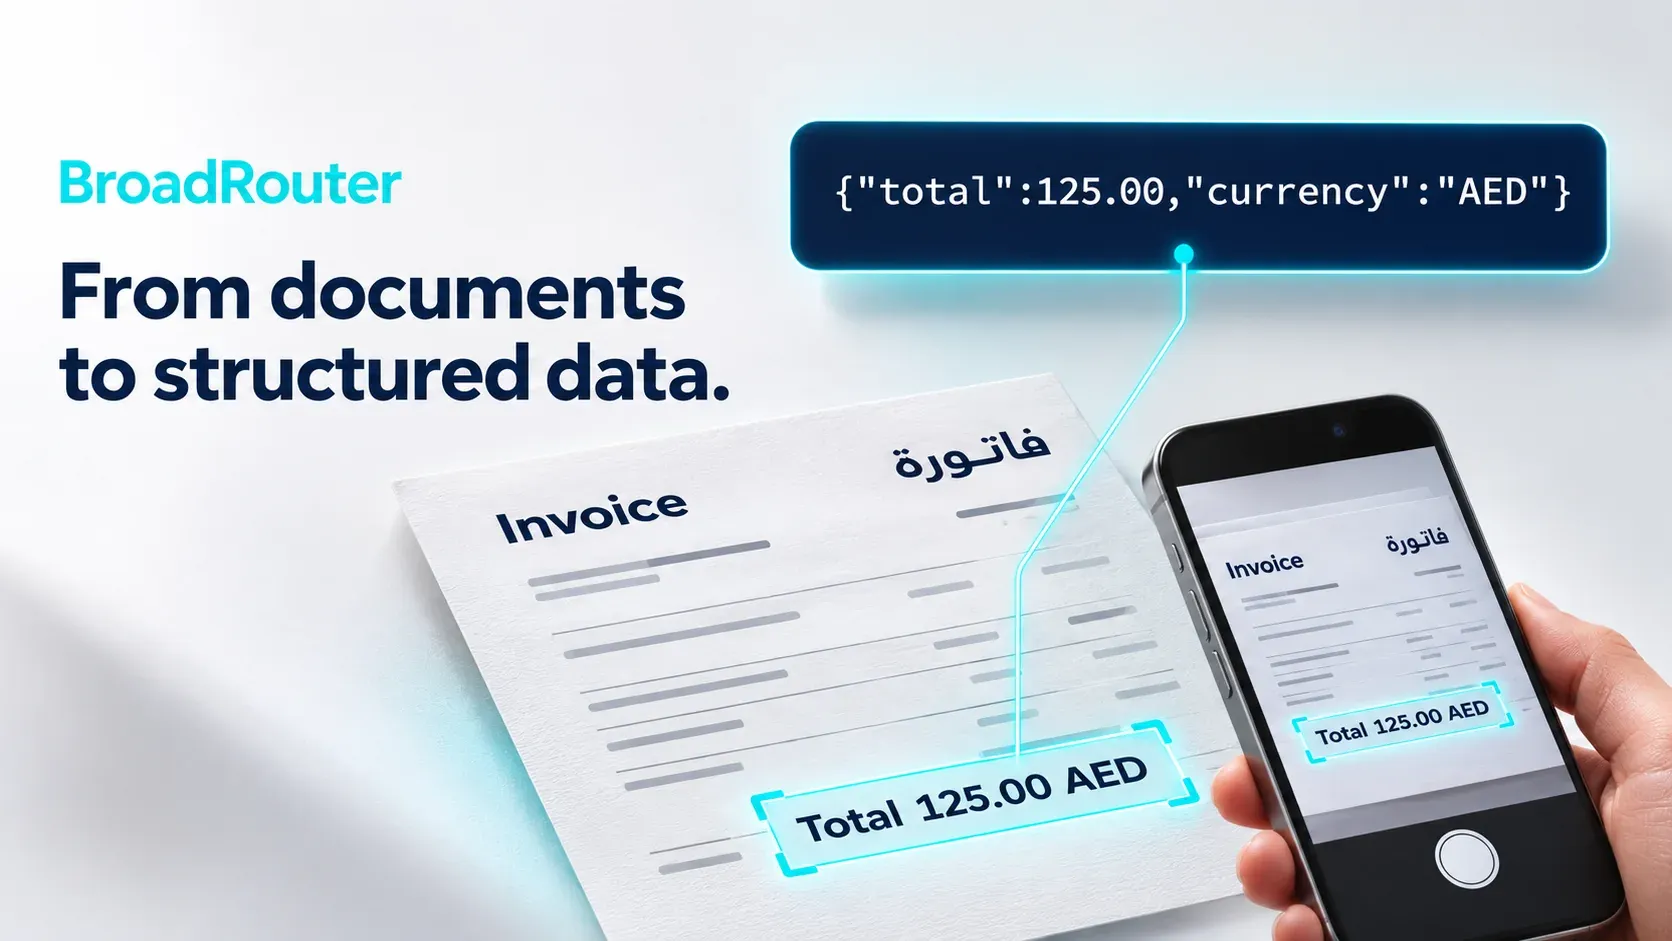
BroadNet Inference 上有三个对话模型可以接收图片:DeepSeek V4.1 Flash、Qwen3.8 27B 和 BroadNet Gemma 4 VL 26B。GLM 5.3 只支持文本。对于阿拉伯语文档,Qwen3.8 27B 是 BroadNet 做过阿拉伯语测试的那个:写作流畅,能听懂海湾和埃及方言,阿拉伯语与英语互译准确。Gemma 4 VL 26B 是三者中在 BroadNet 上最便宜的,可以用免费额度运行。
针对一张发票提问
import base64, os
from openai import OpenAI

client = OpenAI(base_url="https://inference.broadnet.ai/v1", api_key=os.environ["BROADNET_API_KEY"])
invoice = base64.b64encode(open("invoice.jpg", "rb").read()).decode()

response = client.chat.completions.create(
    model="broadnet/gemma-4-26b-a4b",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "ما هو المبلغ الإجمالي في هذه الفاتورة؟"},
        {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," + invoice}},
    ]}],
)
print(response.choices[0].message.content)
这个问题用阿拉伯语问的是“这张发票的总金额是多少?”。PNG 文件请在 data URL 中使用 image/png:MIME 类型必须与文件一致。要根据文件名自动设置:
import mimetypes
mime = mimetypes.guess_type("invoice.png")[0]   # "image/png"
url = f"data:{mime};base64," + base64.b64encode(open("invoice.png", "rb").read()).decode()
拿回结构化字段
要求返回 JSON,并明确说出你想要哪些键:
prompt = (
    "Read this invoice. Reply with JSON only, keys: vendor, date (YYYY-MM-DD), "
    "currency, total (number), vat (number or null). Keep the vendor name in Arabic if it is written in Arabic."
)
response = client.chat.completions.create(
    model="broadnet/qwen3.8-27b",
    max_tokens=2000,  # Qwen3.8 27B reasons first
    messages=[{"role": "user", "content": [
        {"type": "text", "text": prompt},
        {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," + invoice}},
    ]}],
)
Qwen3.8 27B 会先思考再回答,所以要给它留出空间。见为什么推理模型会返回空回答。BroadNet 的文档为 Qwen3.8 27B 列出了结构化输出;JSON schema 的一般用法见结构化输出。用 json.loads 解析回复,并在存储之前检查各字段。
费用
按量付费时,图片按模型的输入价格以输入 token 计费,所以很大的照片请先缩小;图片 token 计算器可以算出某个尺寸要花多少 token。在不限量 DeepSeek V4.1 Flash 套餐上,图片也包含在不限量使用之内。
对比各视觉模型的价格,或者在阿拉伯语 OCR API 对比中看看视觉模型与 Google、Azure、Textract 和 Mistral OCR 相比如何。
故障排查
- Qwen3.8 27B 或 DeepSeek V4.1 Flash 返回空回答。 思考用完了
max_tokens。调高它,或者把reasoning_effort设为low。 - 图片报 400 或 422。 检查 data URL 是否以
data:image/jpeg;base64,或data:image/png;base64,开头,以及 MIME 类型是否与文件一致。 - 模型报 403 或其他错误。 GLM 5.3 不接收图片,Qwen3.8 27B 和 DeepSeek V4.1 Flash 需要充值。可以用免费额度运行 BroadNet Gemma 4 VL 26B。
- 请求过大或上下文错误。 大照片会用掉很多 token,而 Gemma 4 VL 26B 的上下文窗口是三者中最小的(见 pricing.json)。把图片缩到合适的宽度,或者只裁剪出总金额区域。
- 总金额错误或数字颠倒。 同一张收据上可能同时出现阿拉伯-印度数字(٠١٢٣)和拉丁数字。要求模型用拉丁数字返回数值,并在代码里用明细行核对总金额。
- JSON 无效。 要求“只返回 JSON”,解析前去掉可能存在的代码围栏,解析失败时重试一次。